数据类型-列表与元组
在阅读本系列课程时,你需要跟着老师的课程代码在自己的Python 环境中输入运行,加深认识理解哦。
一 列表
1. 列表类型基本介绍
在[]内用逗号分隔,可以存放n个任意类型的值,用于标识:存储多个值的情况,比如一个人有多个爱好,定义格式示例:
students=['albert','james','kd',]
# 或者students=list(['albert','james','kd',])
列表可以存储多个值,是有序的,是可变类型,不可以哈希。
2. 列表类型常用的方法
(1) 添加元素
append方法 在列表最后追加元素
l1 = ['a', 'b', 'c', 'd', ]
l1.append('e')
print(l1)
print(l1.append('e'))
# 在队尾追加,没有返回值

# ['a', 'b', 'c', 'd', 'e']
# None
insert方法 在列表中插入元素
l1 = ['a', 'b', 'c', 'd', ]
l1.insert(3,'x') # 3 指定插入索引3这个位置,就是“d”,这个位置,把‘d’ 顶到了后面
print(l1)

# insert可以指定插入的位置

# ['a', 'b', 'c', 'x', 'd']
extend方法 在列表中同时插入多个元素,extend方法使用以及与append方法的区别
append是整体添加
l1 = [1, 2, 3, 4, 5, ]
l1.append([6, 7, 8, 9, ])
# l1.append(*[6, 7, 8, 9, ])  # 会报错
print(l1)
l1.extend([6, 7, 8, 9])
print(l1)只能接收一个参数,如果出现打散的情况,还是会被识别成多个参数,因为程序执行执行是从左到右,从上倒下执行的,当出现时这个列表已经被打散了,因而,会被程序识别成被传入了多个参数。
extend是逐个添加
l1 = [1, 2, 3, 4, 5, ]
l1.extend([6, 7, 8, 9])
print(l1)
l1.extend('abc')
print(l1)
l1.extend('a')  # 也是可迭代对象
print(l1)
# l1.extend(1)  # 报错,不可迭代
print(l1)
extend在执行添加的时候,被传入的参数必须是可迭代对象,这样通过迭代就解决了同时传入多个参数的问题,如果你还不知道可迭代对象,放心,你很快就会知道的。
(2) 删除元素
pop删除,有返回值,默认删除列表中最后一个,指定删除索引值
l1 = [1, 2, 3, 4, 5, 6, ]
print(l1.pop())  # 移除列表中的某个元素,默认是最后一个元素,这个是有返回值的,
因为这是一个可迭代类型和我们前面的extend一类
print(l1)
print(l1.pop(2))  # 2指定是列表中的索引值
print(l1)
remove 删除 没有返回值,没有默认值,指定被删除的元素
l1 = [1, 2, 3, 4, 5, 6, ]
print(l1.remove(2)) # 注意这个2 是列表的元素2,不是索引值,和上述pop区分清楚,
pop移除的是索引值所对应的元素
# print(l1.remove())  # 报错
print(l1)
clear 删除 保留列表名称,清空里面的值
l1 = ['a', 'b', 'c', 'd', 'e', 'b', 'c']
l1.clear()
print(l1)
del 删除 通用删除 但是一般不用
l1 = [1, 2, 3, 4, 5, 6, ]
del l1[2]  # 按索引l1[0] = 1,l1[1]=2,l1[2]=3
print(l1)
l1 = [1, 2, 3, 4, 5, 6, ]
del l1  # 在内存中删除l1 相当于没有定义l1
# print(l1)  # 报错
(3) 更改元素
注意与insert插入的不同,都是以原来的为位置为参照,insert是挤开,本质是添加,而这里是替换
l1 = [1, 2, 3, ]
l1[2] = 4# 将索引2所代表的元素替换为4
print(l1)
(4) 查找元素
按照索引或者指定列表中的元素查找
l1 = ['a', 'b', 'c', 'd', 'e', 'b', 'c']
print(l1.index('a'))  # 返回a在l1的索引值
print(l1.index('b',1,4))  # 两个数字分别对应起始位置和结束位置
print(l1[0:5])  # 按照索引取值和字符串的用法相同
print(l1[:5])
print(l1[0:5:2])
print(l1[:-1])
print(l1[:-2])
print(l1[5:1:-2])
把列表分段查找
l1 = ['a', 'b', 'c', 'd', 'e', 'b', 'c']
a = int(len(l1)/2)
print(l1[:a])  # 从中间位置开始,列出前面所有的元素
print(l1[a:])  # 从中间位置开始,列出后面所有的元素
使用enumerate对列表枚举
l1 = ['a', 'b', 'c', 'd', 'e']
for i, x in enumerate(l1, 100):  # 100指定枚举开始的数字
    print(i, x)
(5) 统计长度
print(len([1,2,3,4,]))(6) 统计元素个数
print(['a','b'].count('a'))(7) 排序
reverse 反序排序
l1 = ['a', 1, 'b', 'c', 'd', 'e', 'b', 'c']
l1.reverse()
print(l1)
sort 按照ascii码来进行排序
l1 = ['a', '1', 'b', 'c', 'd', 'e', 'b', 'A', 'Z', 'c']
l1.sort()
print(l1)
l1.sort(reverse=True)
print(l1)
(8) 复制列表
l1 = ['a', '1', 'b', 'c', 'd', 'e', 'b', 'A', 'Z', 'c']
print(l1.copy())
(9) Python中的赋值,浅拷贝与深拷贝区别
赋值
对于复制的操作,最简单的就是赋值,指的是新建一个对象的引用,新建目标对象与原来的目标对象指向同一个内存地址,**赋值只相当于增加了一个引用,并没有开辟新的内存空间。**如下图所示
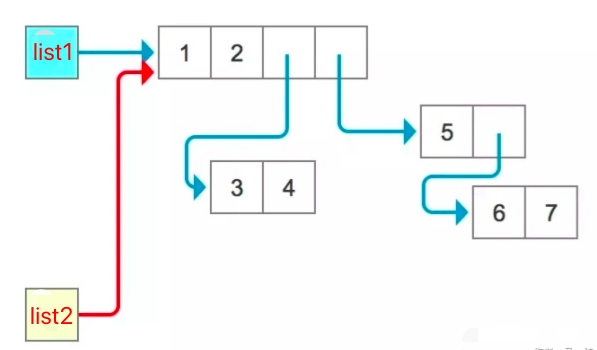
用 id 验证下就知道, list1 和 list2 仍然是同一个东西 。那么他们内部的元素自然也是一样的,对其中一个进行修改,另一个也会跟着变:
list1 = [1, 2, [3, 4], [5, [6, 7]]]
print('list1:', id(list1))
print([id(i) for i in list1])
list2 = list1
print('list2:', id(list2))
print([id(i) for i in list2])
print(list1 is list2)
print(list1[0] is list2[0])
print(list1[2] is list2[2])
list2[0] = -1
print(list1)
list2[2][1] = -1
print(list1)
因此有人将此操作称为“ 旧瓶装旧酒 ”,只是多贴了一层标签,这不能达到我们的目的。要得到一个对象的“拷贝”,我们需要用到 copy 方法。
浅拷贝
浅拷贝顾名思义就是拷贝的比较浅,我们可以把赋值认为是新建了一个对象的引用,把原来被对象内存空间的数据指向新的变量,这时同一块内存空间指向两个变量。浅拷贝与赋值不同,既然是拷贝,那么就是要开辟一块新的内存空间,复制的是原来被拷贝对象内多个元素对象的引用,有几个元素对象就赋值几个元素对象的引用,也有人把这种操作称为“新瓶装旧酒”。不过,如果旧的酒瓶里面如果还套了一个酒瓶子,那你就需要注意了。因此,不论是对拷贝对象或者是被拷贝对象内一个可变类型元素内的元素的修改(包含添加,修改和删除),都会引起另外一方的变化。但是,如果是直接对对象内的一级元素当作一个整体进行修改(这时对可变类型元素的元素只能是删除),虽然他们的元素有共享的内存地址,但是拷贝对象或者被拷贝对象元素内的引用都是独立的,删除了其中一方的一个引用,另外一方的引用依然存在。
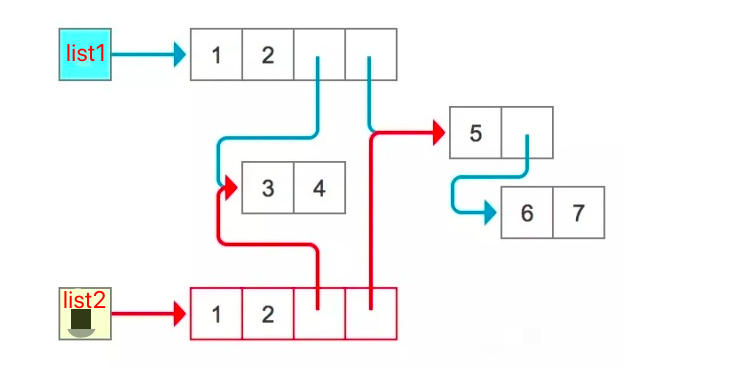
from copy import copy

list1 = [1, 2, [3, 4], [5, [6, 7]]]
print('list1:', id(list1))
print([id(i) for i in list1])
list2 = copy(list1)
print('list2:', id(list2))
print([id(i) for i in list2])

# 1 判断论证过程
print(list1 is list2)  # id不同自然不是,id用来形象表示内存地址
print(list1[0] is list2[0])  # 两者之间对应的元素都指向同一个地址
print(list1[2] is list2[2])

# 2 对一级元素整体修改论证(其实此时可变类型元素也只能当作不可变来修改)
list1[0] = -1  # 修改列表1或2都是单独变化的
print(list1)
print(list2)

list2[1] = -2
print(list1)
print(list2)

list1[2] = -3
print(list1)
print(list2)

list2[2] = -30
print(list1)
print(list2)

# 3 给对象添加元素
list1.append('add1')
print(list1)
print(list2)

list2.append('add2')
print(list1)
print(list2)

# 4 删除
list1.pop()
print(list1)
print(list2)

list2.pop()
print(list1)
print(list2)

list1.pop()
print(list1)
print(list2)

# 5 只有对对象内一个可变类型元素内的元素的修改(包含添加,修改和删除),才会同步变化
list2[-1][0] = '5->55'
print(list1)
print(list2)

# # 换成list1也是一样,但需要把上面的部分代码注释掉,确保索引位置不会出错
# list1[3][0] = '5->55000'
# print(list1)
# print(list2)
深拷贝
深拷贝其实与浅拷贝有本质的区别,它不会复制任何的引用,对象内的所有元素,子元素,孙子元素,重孙元素,曾孙元素的数据都是由复制而来,因此,这样的操作被称为“新瓶装新酒”。它的实现原理就是递归,只要任意元素内仍然有子元素,就会复制子元素的数据放到新的内存地址。既然这样,在使用深拷贝后,被拷贝对象的改变,不会引起拷贝对象的任何改变。
import copy

list1 = [1, 2, 3, 4, 5, [6, 7, 8, ]]
list2 = copy.deepcopy(list1)
print(list1)
print(list2)

list1[5].append(9)
print(list1)
print(list2)

list1.append(6)
print(list1)
print(list2)

list1.pop()
print(list1)
print(list2)
复制与深浅拷贝总结:
- 赋值:新建一个原来对象内存地址的引用,对象本身不开辟新的内存空间;
- 浅拷贝:新建多个原来对象内一级子元素内存地址的引用,对象本身需要开辟新的内存空间;
- 深拷贝:复制原来对象内的所有N级子元素的数据,所有的数据都开辟新的内存空间。
二 元组
与列表类型相比,非常类似只不过[]换成(),作用:用于存储多个值,对比列表来说,元组不可变(是可以当做字典的key的),不可更改,主要是用来读。
age=(11,22,33,44,55)
# 本质age=tuple((11,22,33,44,55))
元组可以存储多个值,是有序的,是不可变类型,可以哈希。元组常用的方法,请参考列表常用方法,需要注意的是,元组只能取值,而不能改变元组的值