NLP 第 10 / 12 篇
数据不平衡
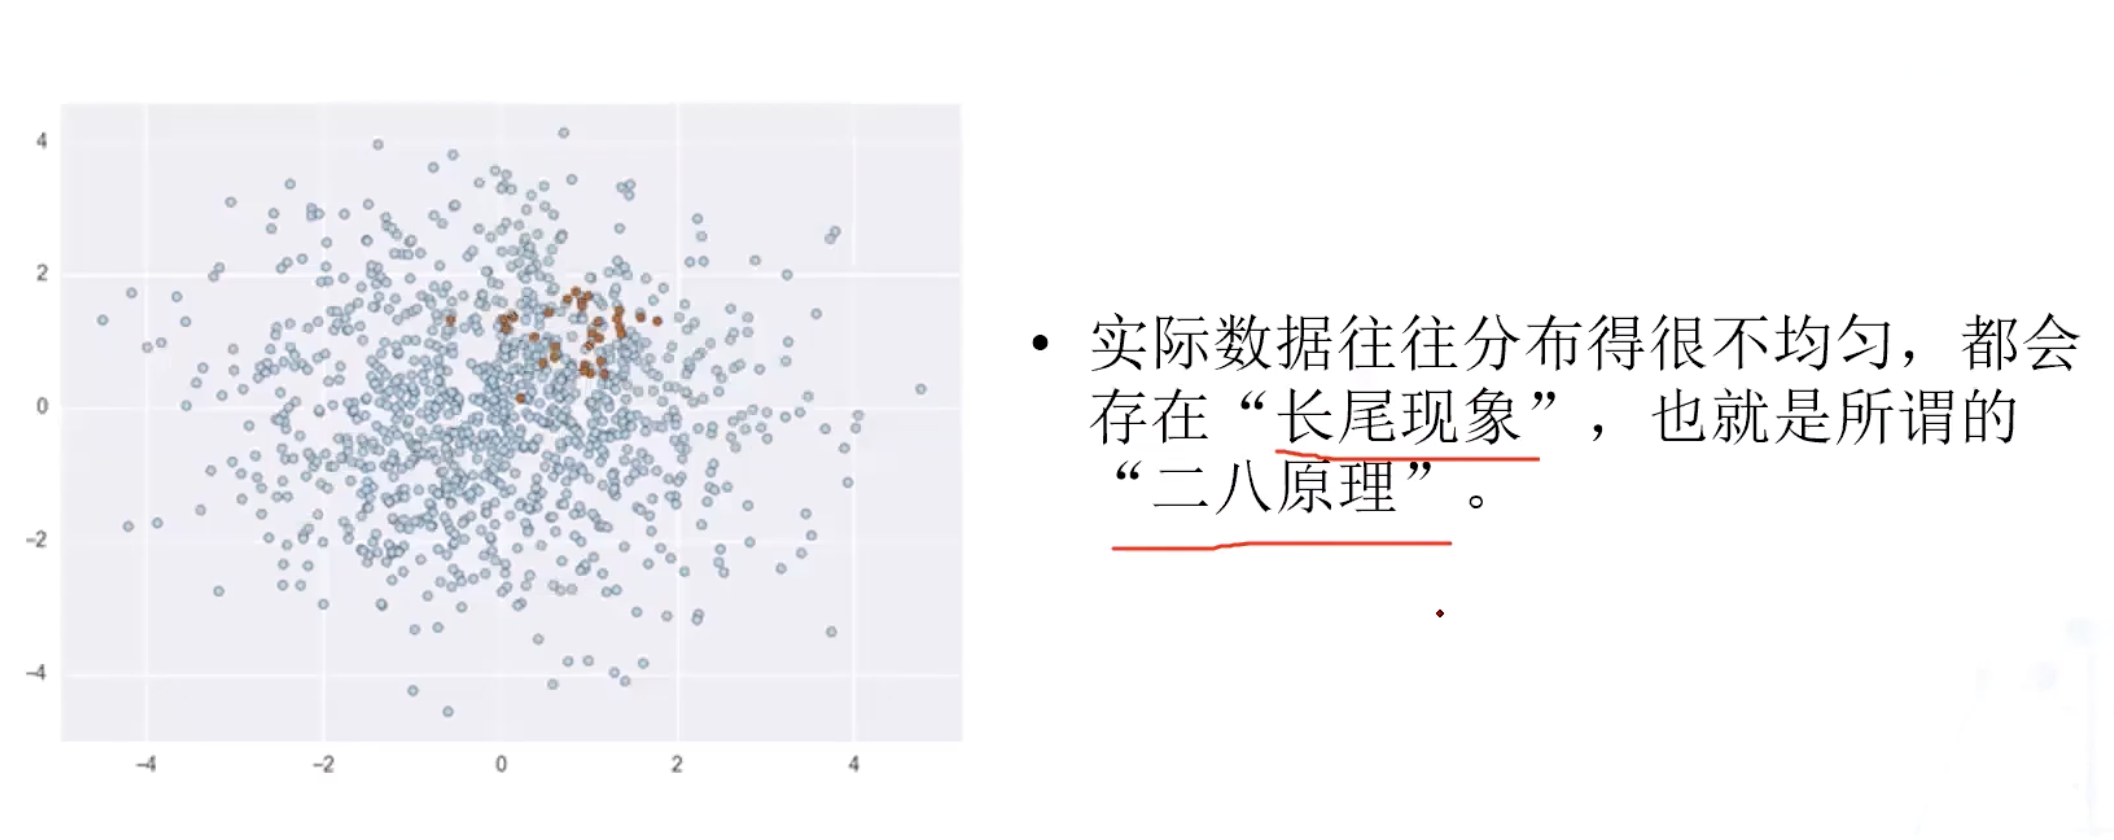
比如有错误的文本要比正常的文本要少
处理数据不平衡-数据重采样
主要包括两个方面:
- 上采样Over-sample:增加量少的样本数,最简单的方式直接随机复制
- 下采样Under-sample:删除量多类别的样本数
方法:
- 随机方式,可能会造成过拟合的现象
- 基于聚类来进行,对于需要上下采样的类别分别独立地进行聚类计算,在对其中的聚类类别进行上下采样
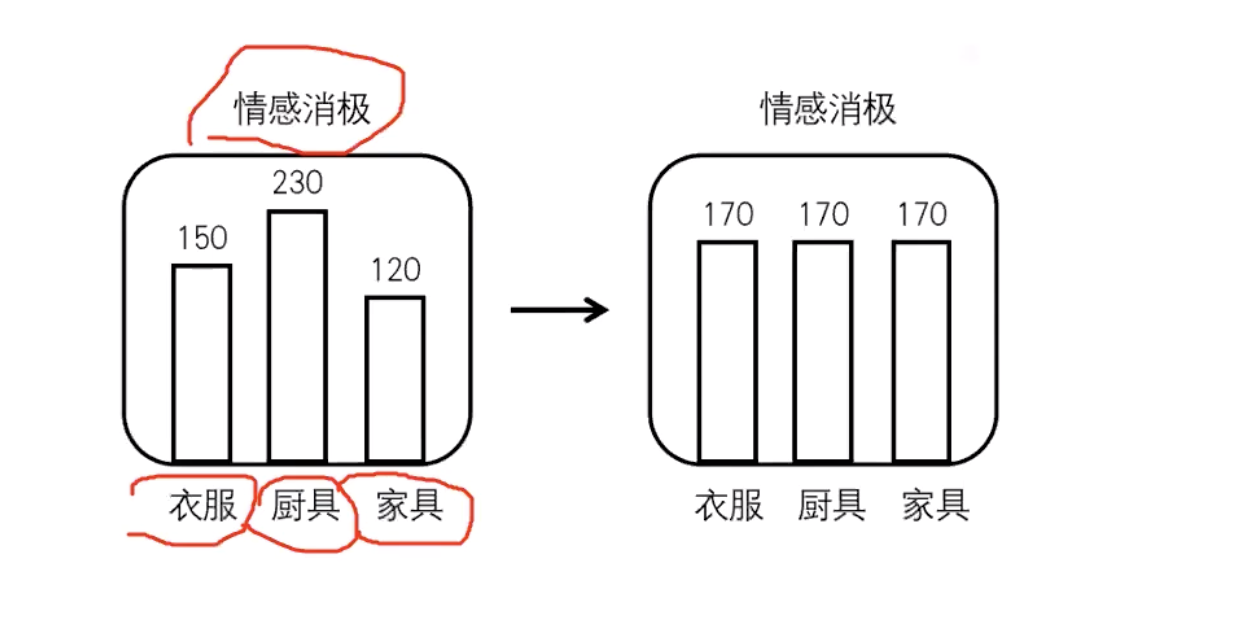
如上图所示,让不同的聚类类别达到一个均衡的状态
样本合成
最简单的方式是从数量小的类别随机采样属性合成新样本,比如可以使用朴素贝叶斯分类器的反向过程,独立的采样每个属性,进而合成新样本
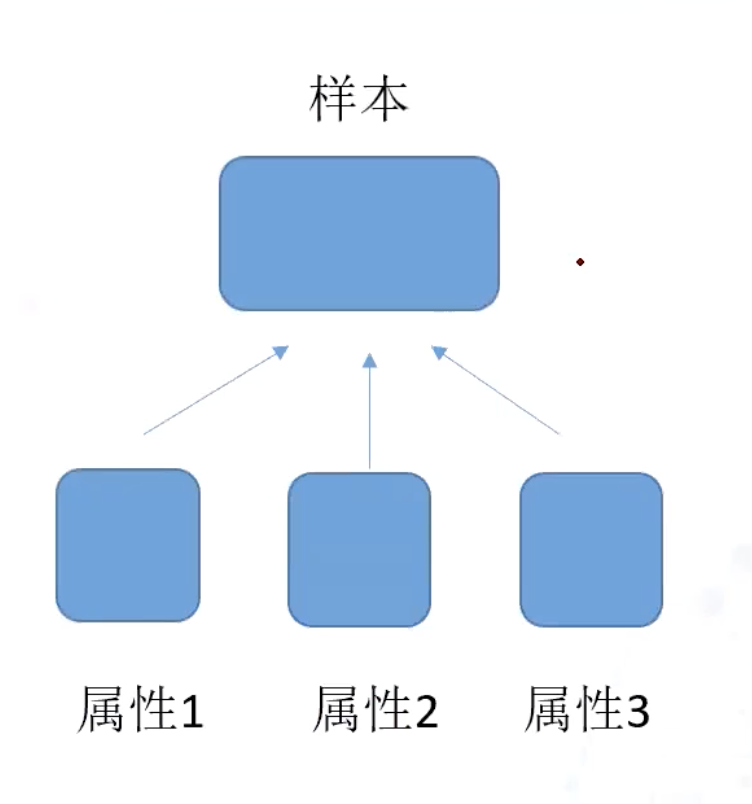
这种重生数据的方式可以缓解重复采样中的过拟合问题,但无法体现真实数据中属性间的关联性
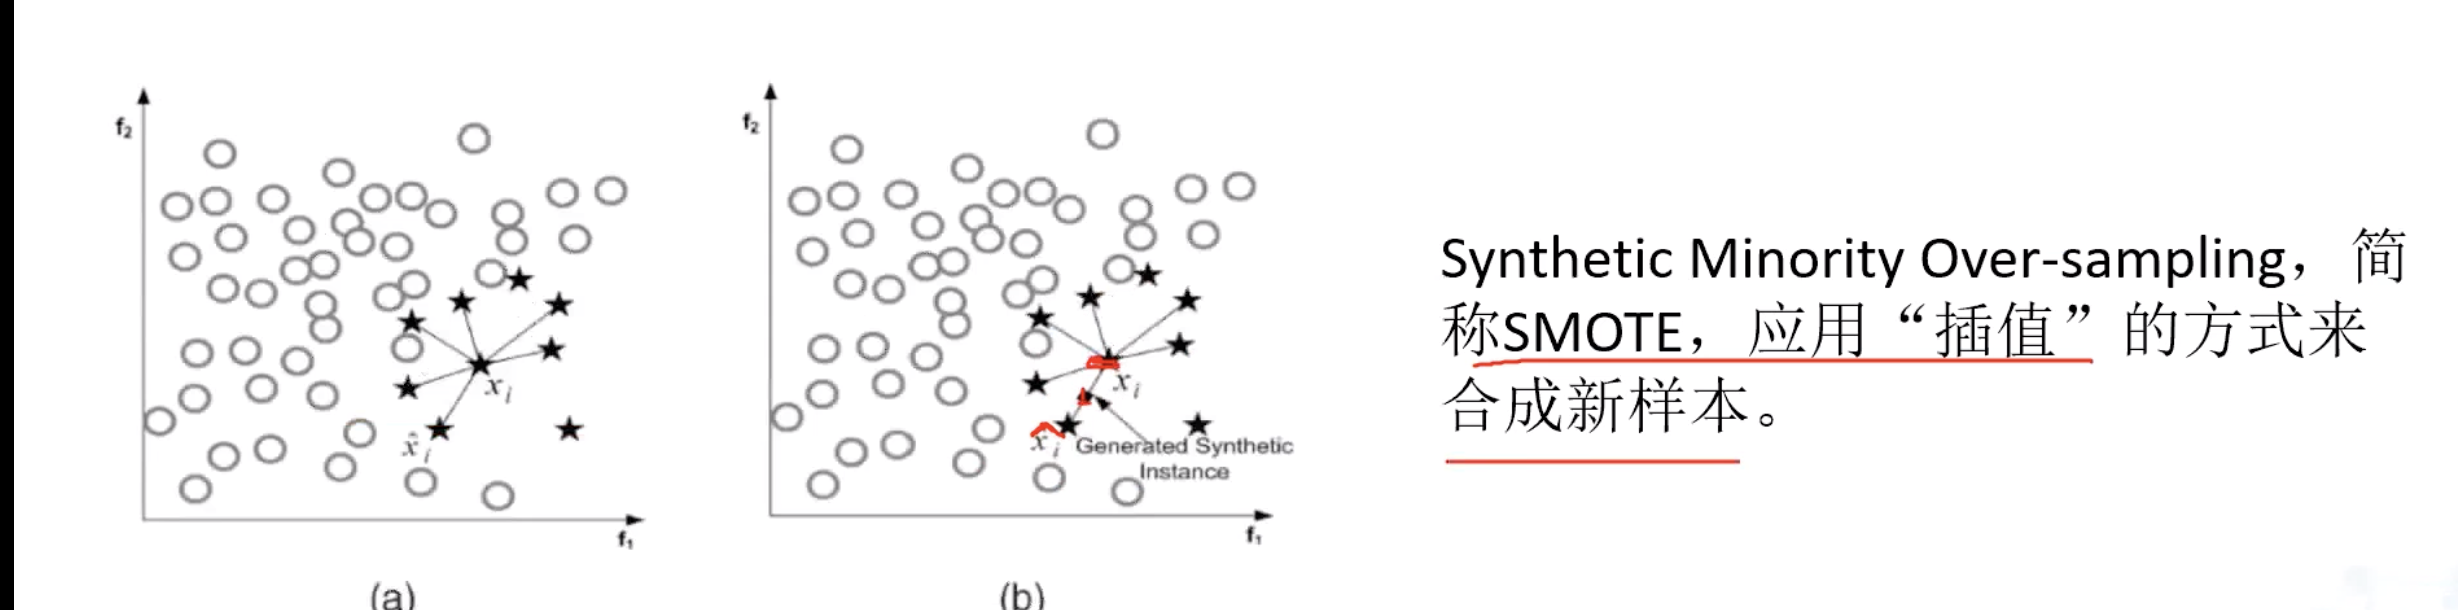
也可以采用上图这种插值的方式来合成新样本
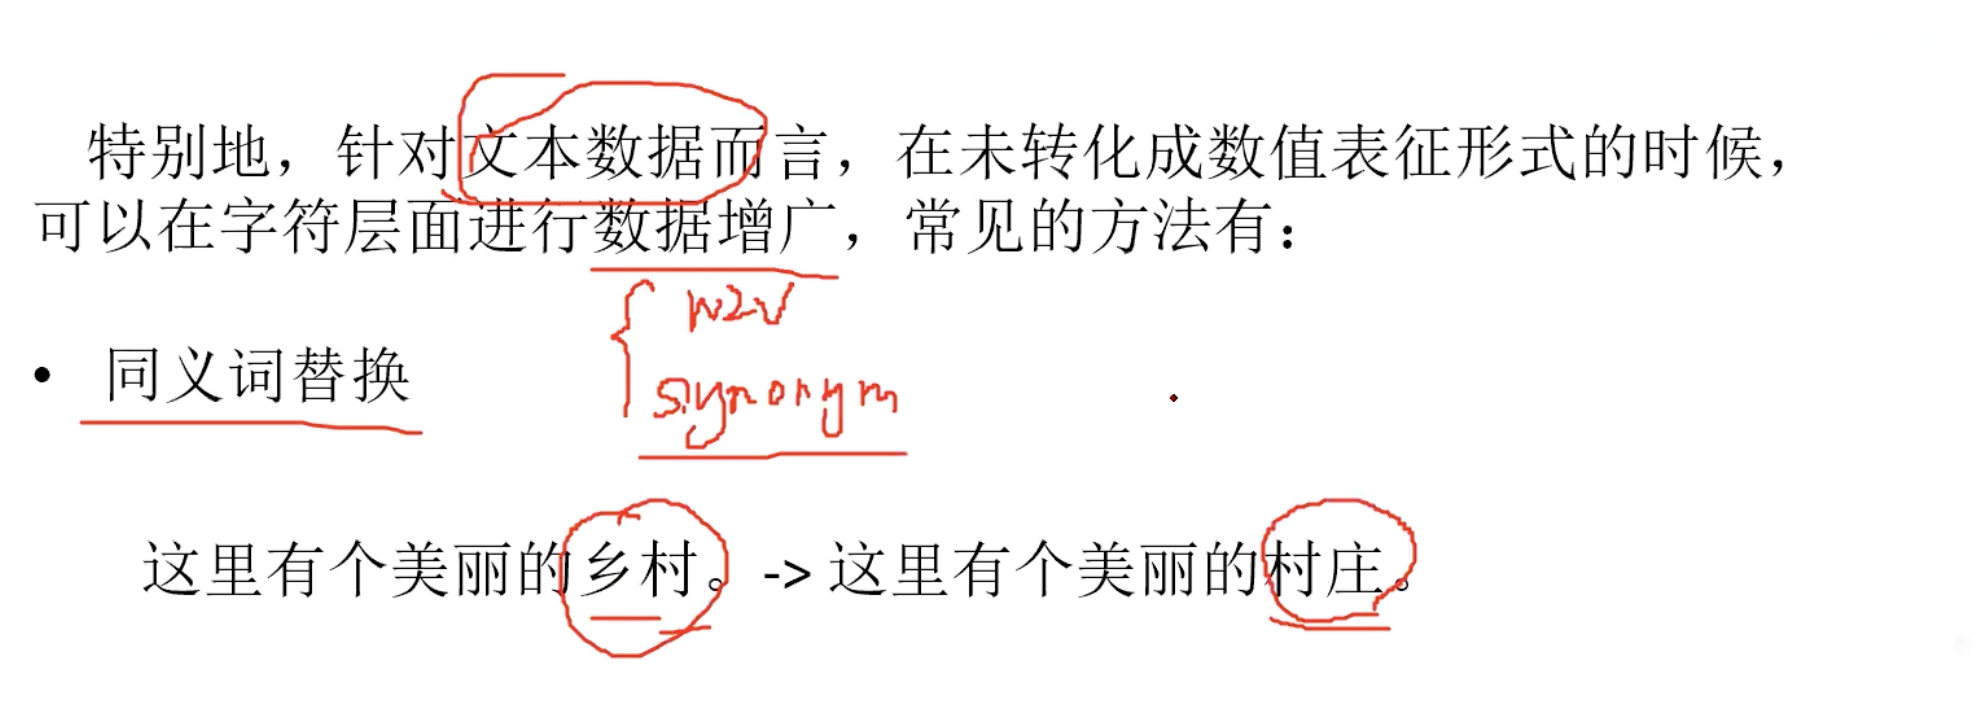
同义词替换
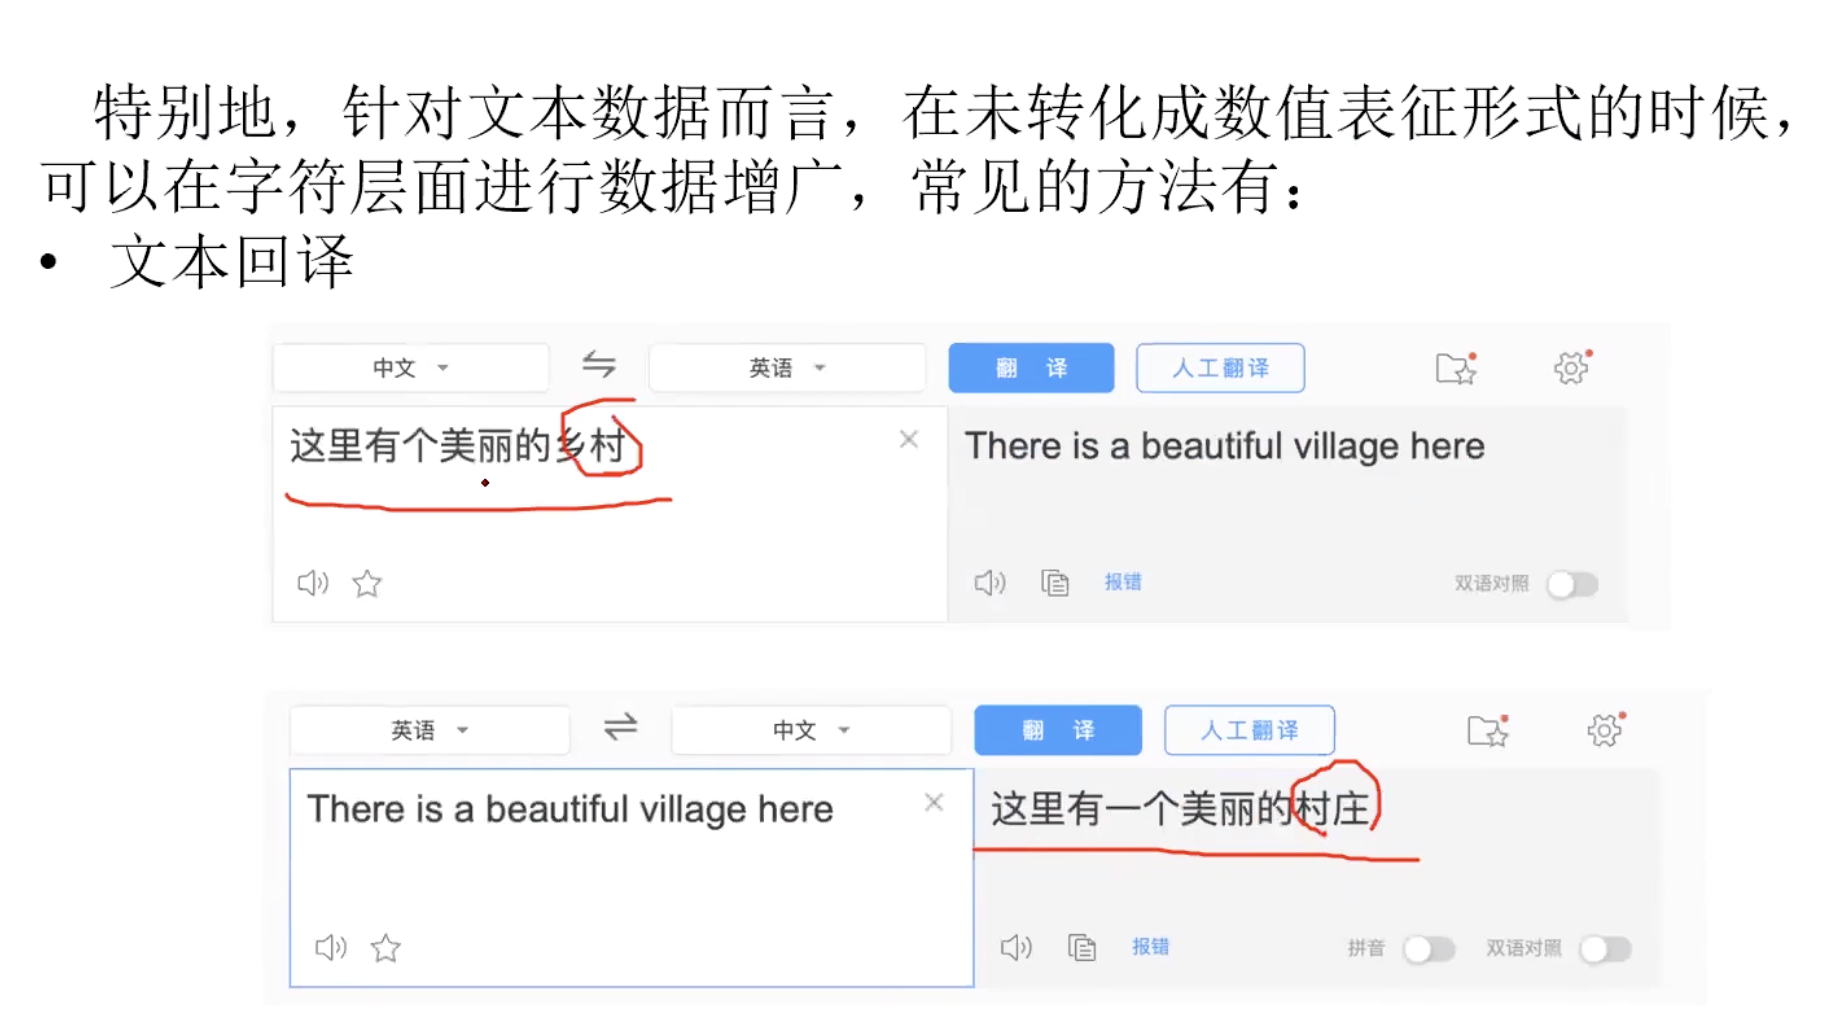
文本回译
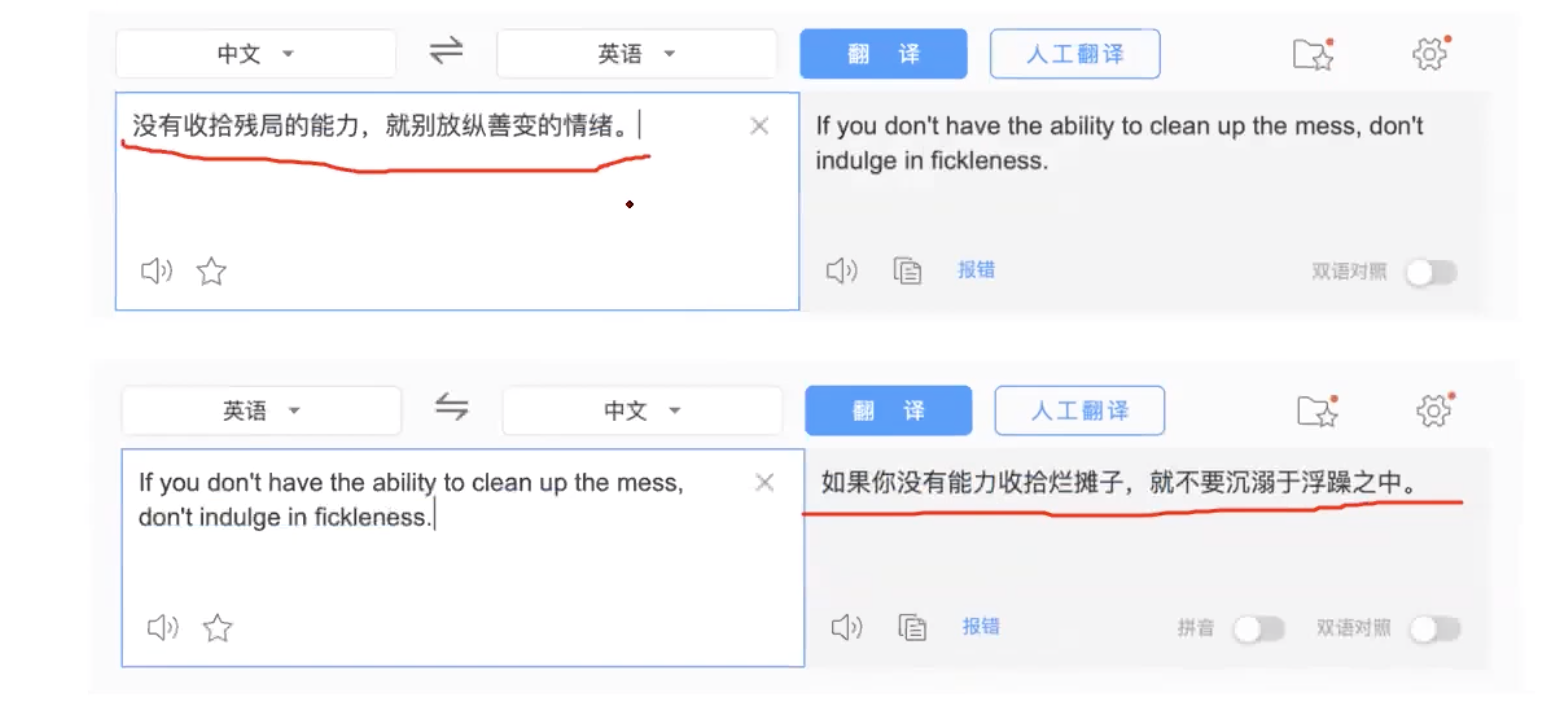
一般我们使用讯飞来做互译会比较好一些,英法互译,中日互译
转换顺序
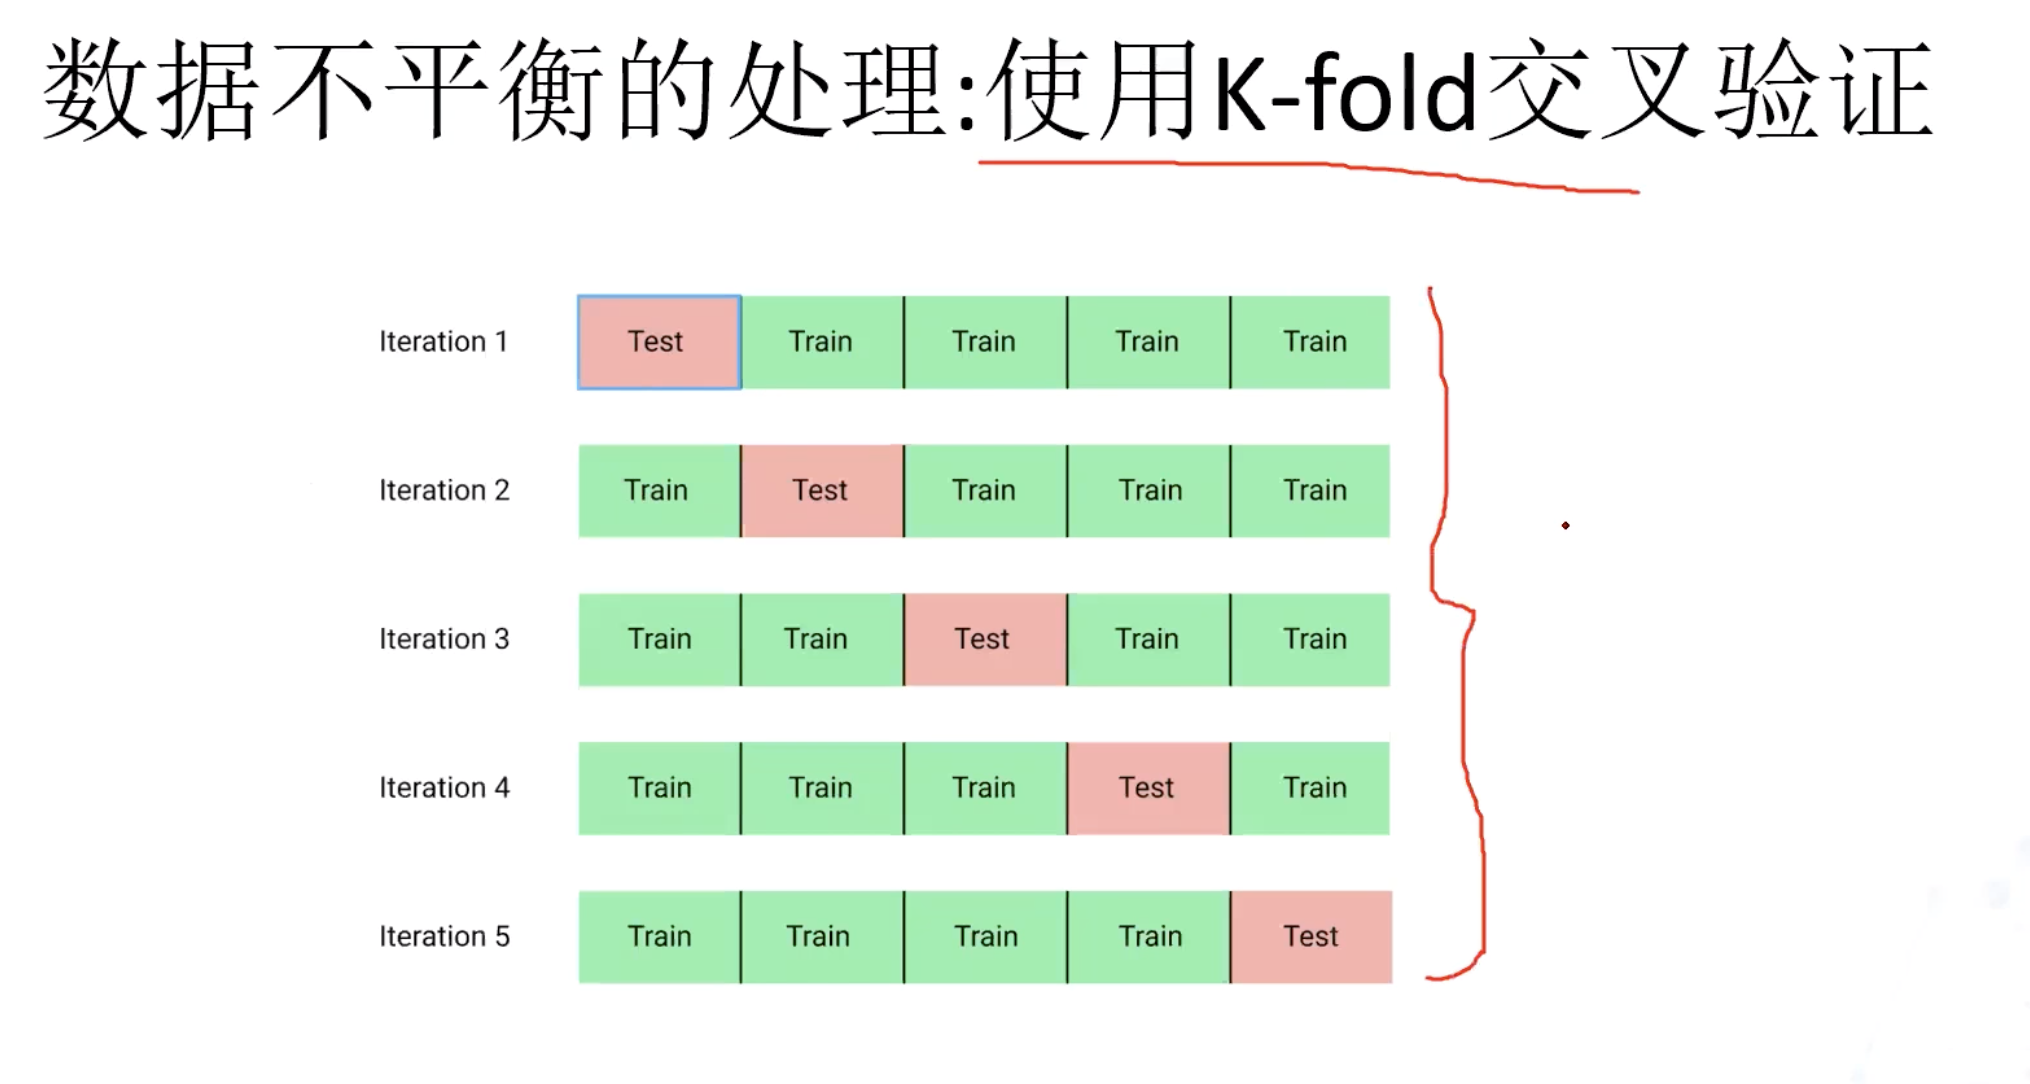
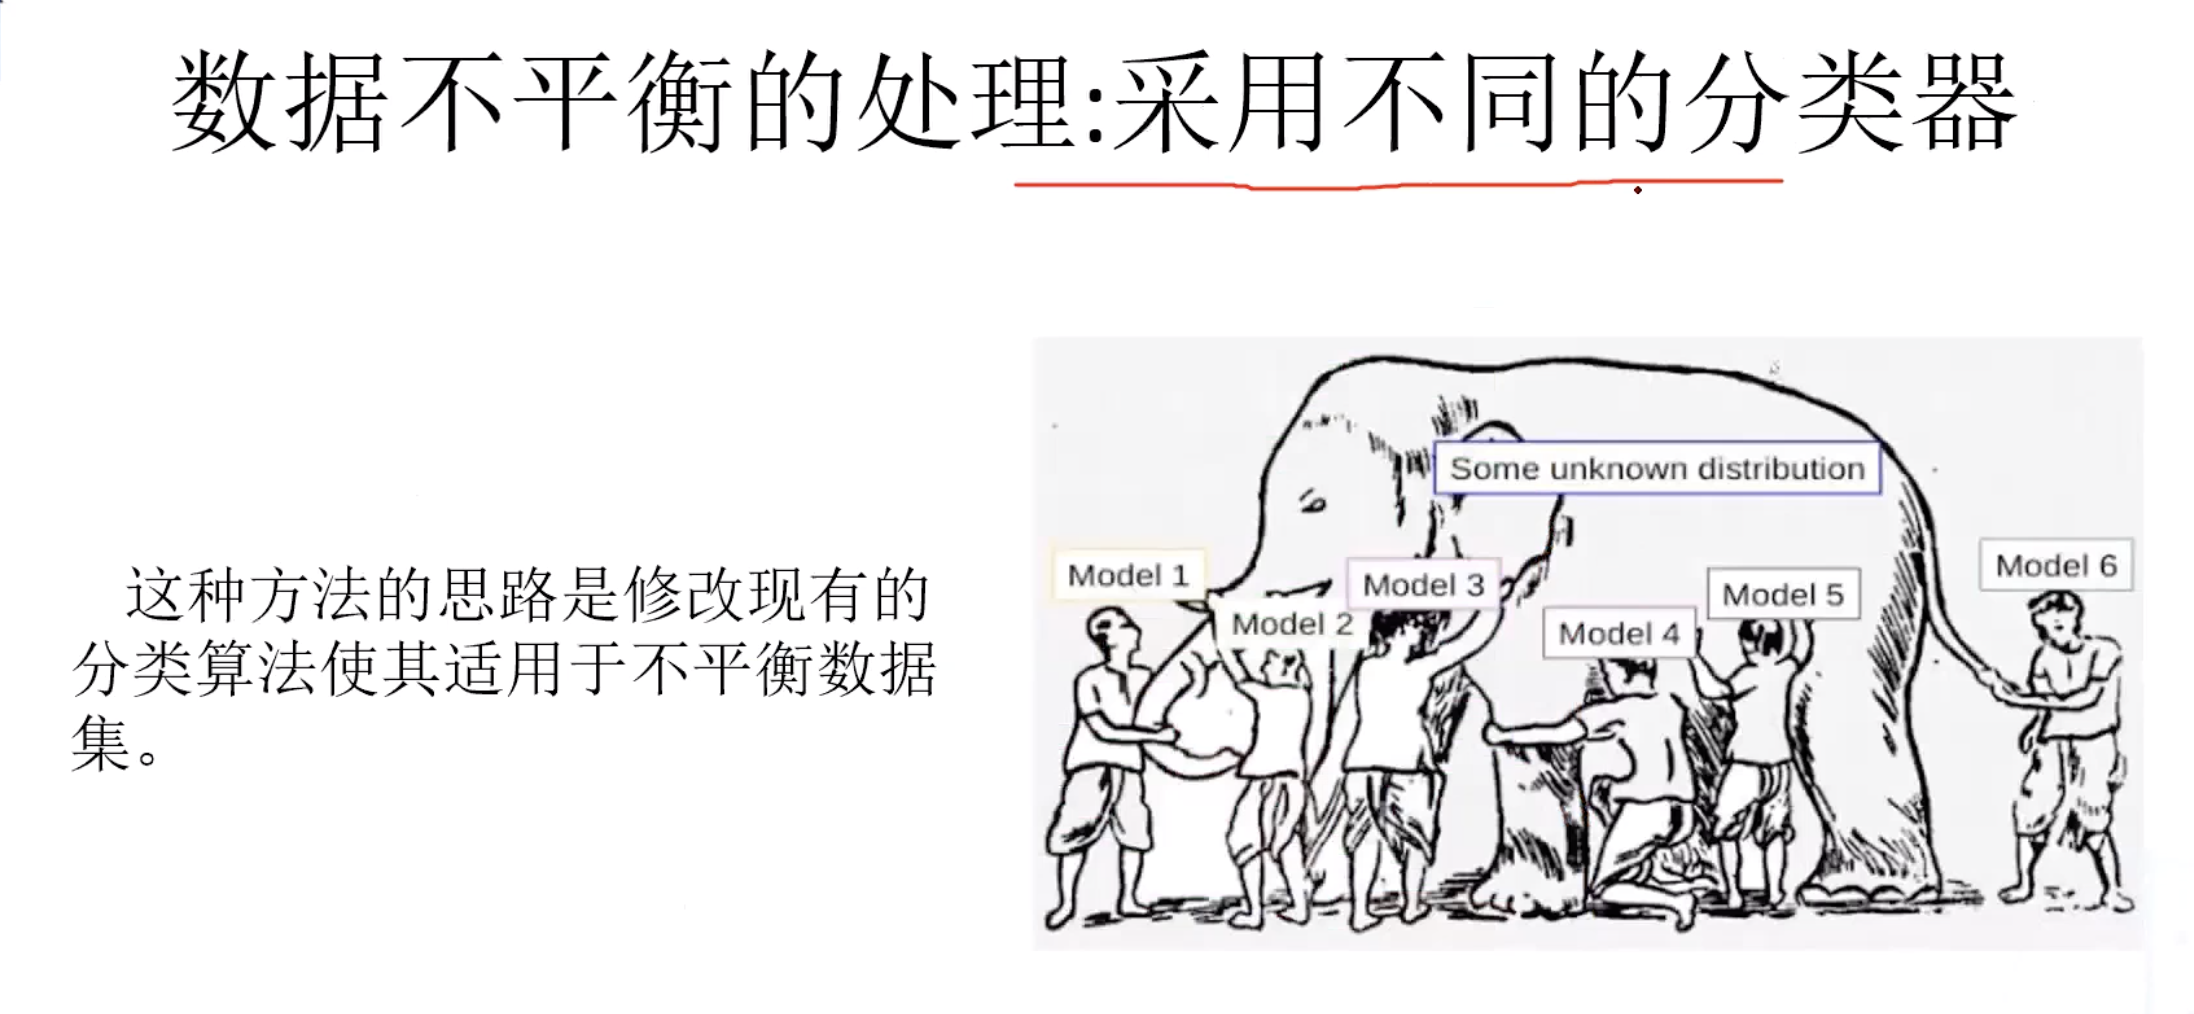
做模型训练的时候可以采用不同的分类器
在公司面用的方法,一本是文本回译和同义词替换这两种方法用的是最多的,数据是一个非常大的问题。
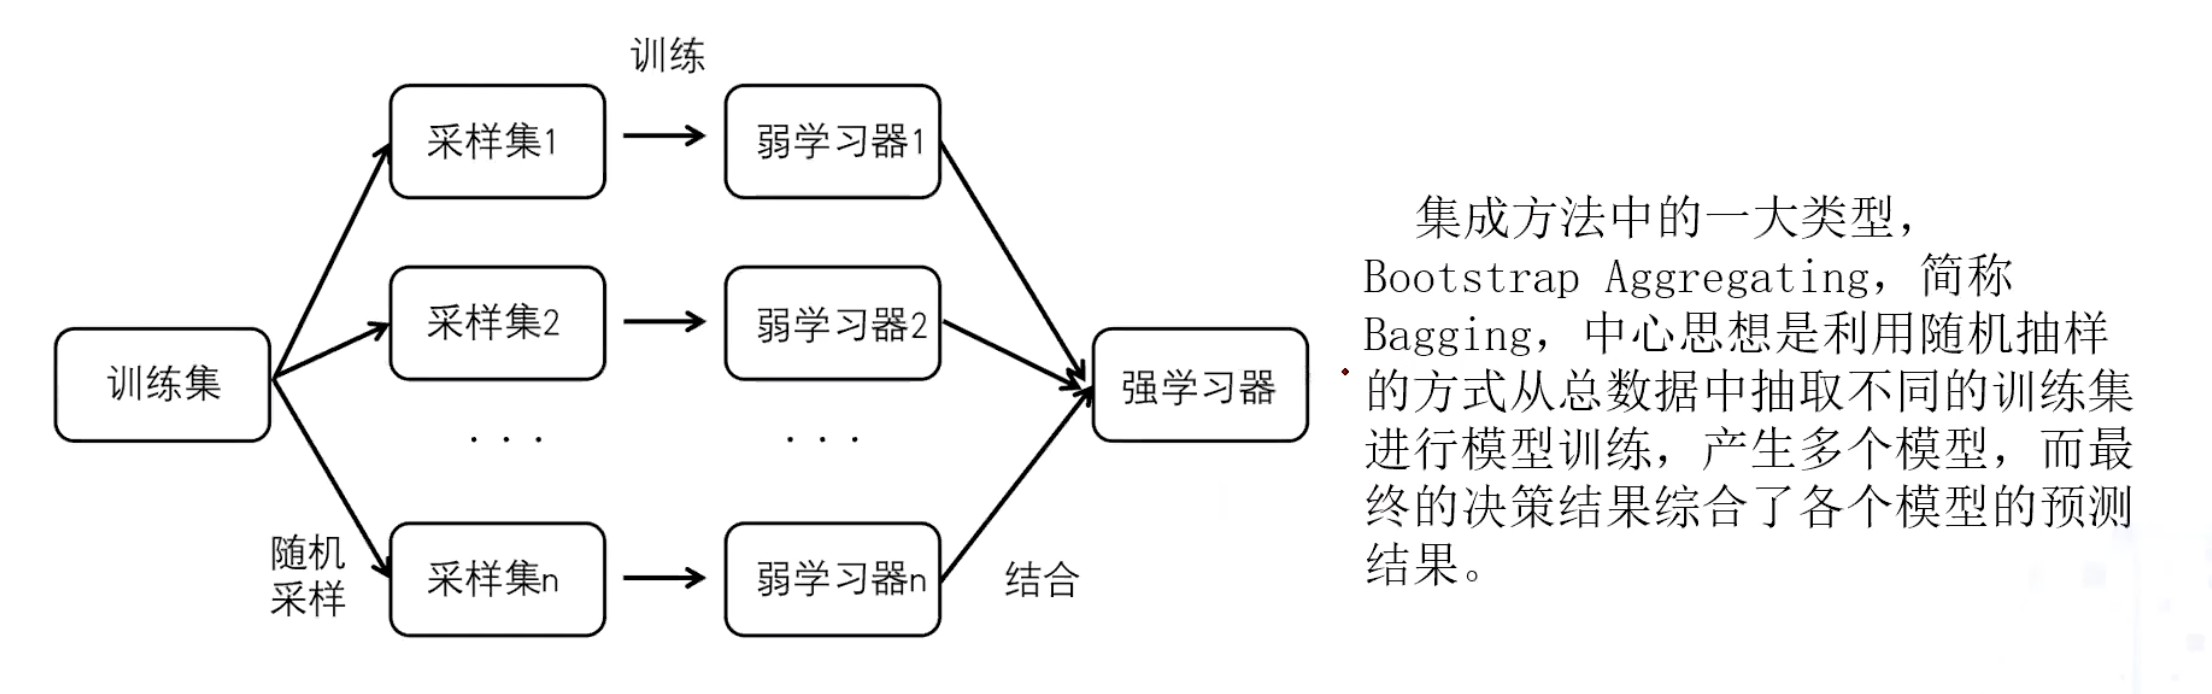
当数据不平衡的时候我们可以采用集成的方法,来完成,具体的集成的方法有两大类:
- Bagging,拿出一部分的数据进行训练,出来一个弱学习器,再把所有的弱学习器集成起来变成一个强的学习器
- Boosting,给每一个训练集分类一个权重,基于不一样的权重来进行训练,根据弱学习器的结果改变对应的权重,然后在学习,最后结合成一个强的学习器。用一种串行的方式学习一个个弱学习器,最后再组合成一个强的学习器
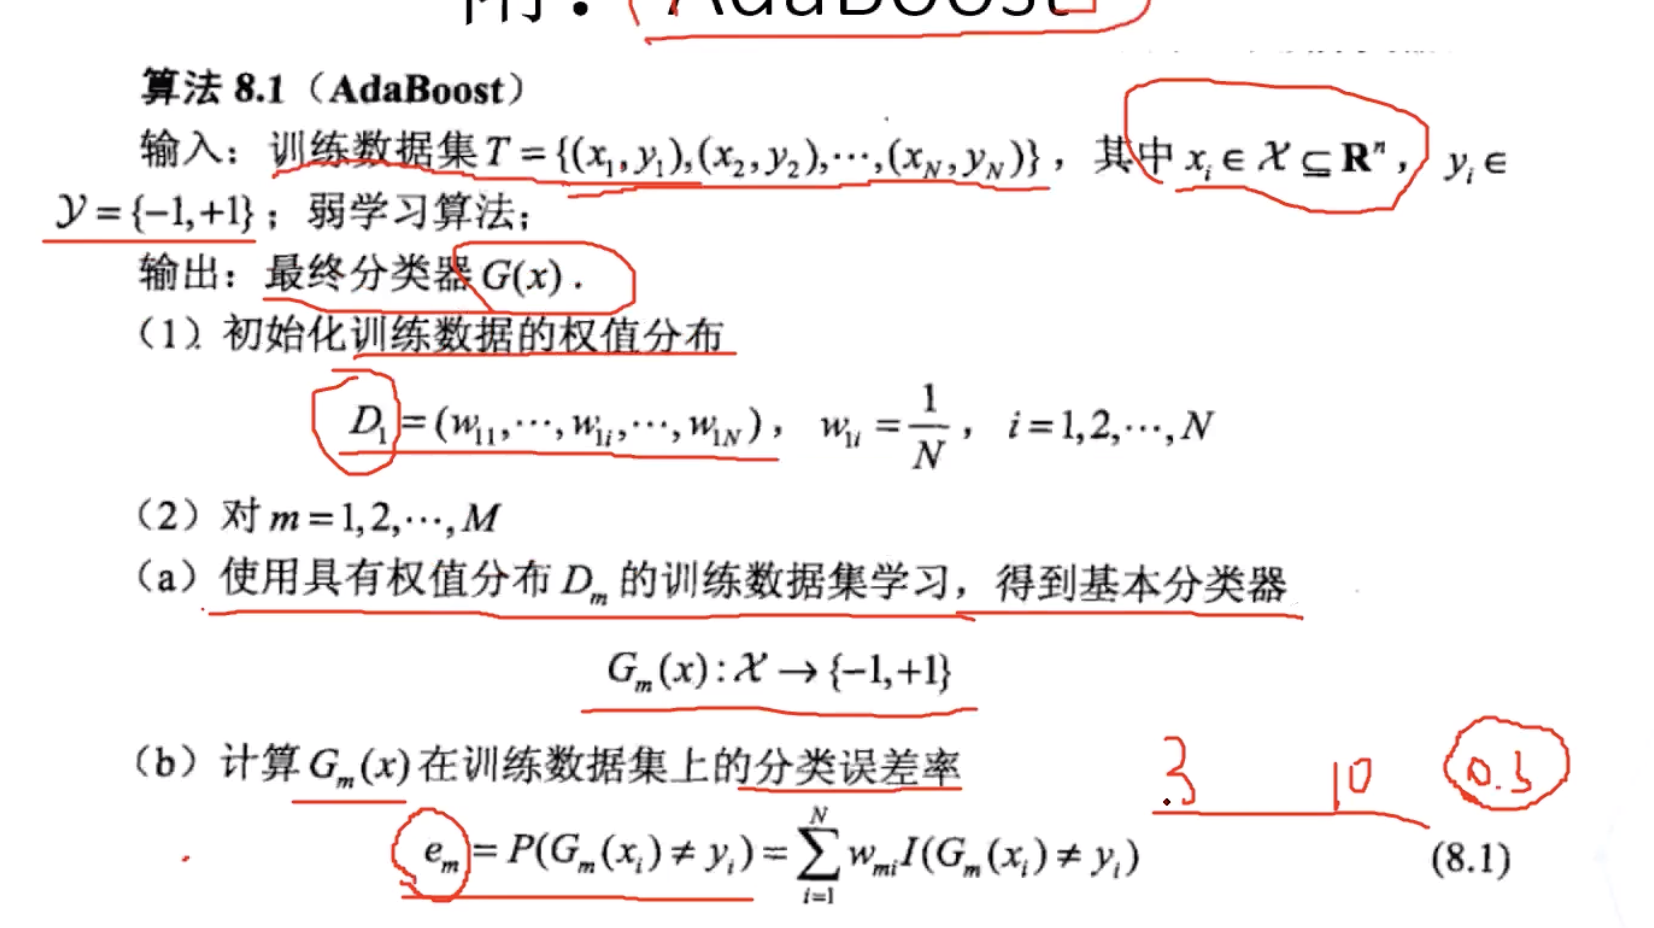
AdaBoost实例说明:
这个例子就是用一种串行的方式来做一个强学习器的过程